Une démonstration soignée peut donner l’impression qu’une API de génération d’images est prête pour la production après seulement quelques prompts. Les problèmes apparaissent généralement lorsqu’une véritable application commence à envoyer des demandes répétitives, ambiguës ou soumises à des contraintes précises.
Une tâche peut nécessiter la création d’une nouvelle illustration à partir d’un texte, une autre doit conserver fidèlement un produit tout en modifiant son arrière-plan, tandis qu’une troisième doit s’adapter à une carte étroite sans perdre le sujet principal.
Si chaque résultat est évalué uniquement selon le critère « l’image est-elle belle ? », certaines défaillances importantes peuvent passer inaperçues.
Une meilleure approche consiste à considérer l’API comme un composant dont le comportement peut être observé et mesuré. Créez un benchmark à partir des tâches que votre application devra réellement traiter, définissez les conditions d’échec avant même de lancer la génération, puis enregistrez les résultats afin de pouvoir les comparer.
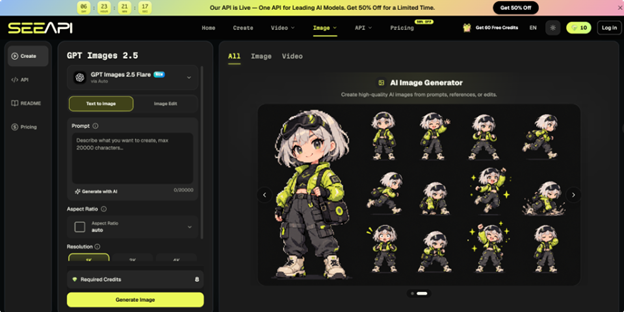
Un service tel que l’API ChatGPT Images 2.5 peut être testé puisque son interface publique prend en charge aussi bien la génération d’images à partir de texte que les workflows basés sur des images de référence. La décision finale doit néanmoins reposer sur vos propres cas de test et vos propres critères d’acceptation.
Commencez par des tâches d’image représentatives
Constituez un petit ensemble de requêtes représentatives de votre produit plutôt que de vous appuyer uniquement sur des prompts conçus pour des démonstrations.
Incluez des cas simples, des situations courantes ainsi que des scénarios susceptibles de provoquer des erreurs.
Pour un outil de publication, cela pourrait par exemple inclure :
- une illustration destinée à un article
- une grande image horizontale de type hero laissant suffisamment d’espace pour intégrer du texte
- un visuel généré à partir d’une image de référence
- une modification ciblée d’une image existante
Enregistrez chaque tâche sous forme de données de test structurées.
Conservez séparément :
- le prompt
- l’éventuelle image de référence
- l’emplacement prévu pour l’image
- les éléments qui doivent impérativement être conservés
- les conditions considérées comme des échecs
Un champ dédié tel que must_preserve, par exemple, facilite considérablement l’évaluation des résultats utilisant une image de référence.
Conservez également un benchmark stable lorsque vous comparez différents réglages ou différents services.
Si vous réécrivez les prompts après chaque résultat décevant, vous finissez par évaluer votre capacité à rédiger des prompts plutôt que la qualité réelle de l’intégration.
Conservez donc une version de référence et enregistrez séparément les modifications apportées par la suite.
Évaluez les résultats selon des modes d’échec clairement définis
Une grille d’évaluation efficace doit distinguer différents types de défaillances.
Une image peut être visuellement séduisante tout en ne respectant pas la demande. Elle peut parfaitement conserver le sujet principal mais rendre le texte incorrect. Elle peut également respecter le prompt tout en étant inutilisable dans l’interface finale.
Évaluez ces dimensions indépendamment afin qu’une qualité particulièrement réussie ne masque pas une autre faiblesse.
1. Vérifiez d’abord le respect du prompt avant la qualité esthétique
Commencez par vérifier si la modification demandée a réellement été effectuée.
Si le brief indique :
« Déplacer la chaise rouge à côté de la fenêtre »,
vérifiez d’abord :
- la couleur de la chaise
- sa nouvelle position
- sa relation avec la fenêtre
Ce n’est qu’ensuite qu’il est utile d’évaluer l’éclairage, la composition ou la qualité artistique de l’image.
Un échec à ce niveau signifie généralement que le modèle a mal compris ou ignoré l’instruction.
Pour les contraintes importantes, privilégiez des scores binaires ou des échelles très simples.
Par exemple : « Chaise déplacée : oui/non » est beaucoup plus utile pour le débogage que : « Composition : 8/10 »
La qualité subjective peut toujours être évaluée, mais uniquement après avoir vérifié que les instructions obligatoires ont bien été respectées.
2. Testez la conservation de l’image de référence avec des modifications contrôlées
Les tests utilisant une image de référence doivent volontairement modifier un seul élément à la fois.
Choisissez une image contenant des caractéristiques facilement reconnaissables, demandez par exemple une modification de l’arrière-plan ou de l’environnement, puis définissez deux ou trois détails qui doivent impérativement rester identiques.
Cette méthode permet de déterminer si le workflow est capable d’effectuer une modification ciblée sans transformer involontairement l’ensemble de l’image.
Pour un cas de benchmark, ChatGPT Image 2.5 peut par exemple être testé en fournissant une image de référence, puis en demandant une modification précise, comme le remplacement de l’arrière-plan, tout en spécifiant clairement les éléments visibles qui doivent être conservés.
Une fois l’image générée, comparez-la directement avec l’image source au lieu de l’évaluer isolément.
Vérifiez dans cet ordre :
- les éléments qui devaient être conservés
- la modification demandée
- l’apparition éventuelle de changements non demandés concernant les objets, le texte ou le cadrage
3. Inspectez le texte et les petits détails visuels
Si votre application dépend de textes lisibles, d’étiquettes, de maquettes d’interfaces, de détails présents sur des emballages ou de petits objets répétés, créez des tests spécialement conçus pour révéler les faiblesses dans ces domaines.
Il peut être utile de zoomer sur l’image générée, mais il faut également l’examiner à la taille réelle à laquelle les utilisateurs la verront.
De petits détails qui semblent acceptables en pleine résolution peuvent devenir illisibles ou disparaître complètement lorsque l’image est affichée sous forme de vignette ou de carte.
Enregistrez précisément chaque erreur.
Par exemple : « Texte incorrect » est moins utile que : « Le deuxième mot est absent » ou : « La forme du logo a été modifiée ».
Des observations précises facilitent ensuite l’évaluation des changements apportés aux prompts ou au workflow.
4. Comparez les variantes à leur taille d’utilisation réelle
Ne choisissez pas un résultat uniquement en l’observant dans une grande fenêtre ou une visionneuse plein écran.
Placez chaque image candidate dans le véritable composant de votre interface ou dans une maquette reproduisant fidèlement son comportement.
Une image hero nécessite par exemple une répartition de l’espace différente de celle d’une vignette carrée dans une galerie.
De même, une image possédant un sujet principal fortement centré peut être très mal recadrée dans un conteneur responsive.
Utilisez exactement le même emplacement et les mêmes contraintes pour toutes les images testées.
Si une version reste exploitable après les recadrages desktop, tablette et mobile alors qu’une autre perd son sujet principal, cette différence doit faire partie de l’évaluation, même si les deux images paraissent tout aussi réussies lorsqu’elles sont regardées séparément.
Mesurez le comportement de l’API dans des conditions de charge réelles
La qualité visuelle ne représente qu’une partie des critères nécessaires pour déterminer si une API est prête pour une utilisation en production.
Enregistrez notamment :
- l’heure de début de la requête
- le temps nécessaire à son traitement
- la réussite ou l’échec de la génération
- la taille du fichier retourné
- le nombre de nouvelles tentatives nécessaires
Un lot de tests relativement modeste mais représentatif du trafic habituel de votre application suffit souvent pour déterminer si votre code client gère correctement les requêtes lentes ou les générations qui échouent.
Testez également les soumissions en double et les sessions interrompues.
Par exemple :
- envoyez exactement la même tâche deux fois
- actualisez la page pendant une génération
- simulez l’envoi d’un fichier non valide
Ces situations permettent souvent de révéler des faiblesses dans la gestion des tâches que de simples tests visuels ne permettent pas d’identifier.
Distinguez également les erreurs de validation des erreurs liées au traitement distant.
Les entrées non prises en charge doivent être rejetées avant leur envoi à l’API.
Si le traitement échoue ensuite côté distant, conservez les données originales de la tâche afin que l’utilisateur puisse relancer la génération sans avoir à tout recommencer.
Il est également important de suivre le nombre de tentatives nécessaires pour obtenir un résultat accepté.
Si une tâche nécessite régulièrement plusieurs générations avant de satisfaire vos critères de validation, son coût réel et sa charge opérationnelle sont plus élevés que ce que laisse penser le tarif d’une seule requête.
Choisissez le workflow que votre produit pourra maintenir dans le temps
Comparez les différents workflows à partir des tâches que votre produit devra effectuer régulièrement.
Concentrez-vous notamment sur :
- le respect des instructions
- la conservation des éléments provenant des images de référence
- l’adaptation des images à la mise en page
- la fiabilité opérationnelle
- le nombre de tentatives nécessaires pour obtenir un résultat acceptable
L’image la plus impressionnante visuellement n’est pas nécessairement le meilleur choix si elle enfreint régulièrement des contraintes importantes.
Conservez votre benchmark même après la mise en production.
Lorsque les prompts, les paramètres, les contraintes de l’interface ou les services utilisés évoluent, relancez exactement les mêmes cas représentatifs et comparez les nouveaux résultats avec ceux qui avaient précédemment été validés.
Avec le temps, ce benchmark devient une véritable suite de tests de régression du comportement visuel.
Il permet ainsi à l’équipe d’évaluer les évolutions de manière cohérente et mesurable, sans dépendre uniquement d’impressions subjectives.